
Vítor Jaime de Oliveira · VitorProDev · Caracas
Bueno, aunque creas que lo sabes, probablemente no. Si eres como la mayoría de las personas y empresas, tus datos confidenciales ya están expuestos, y la IA solo está empeorando el problema. Y está sucediendo justo enfrente tuyo.
El problema: la IA supera a la seguridad, a esto me refiero.
La adopción de la IA avanza más rápido de lo que la seguridad tradicional puede proteger. Según una encuesta de Omdia encargada por IBM (2026) a 400 profesionales de TI y ciberseguridad de Norteamérica, el 31% de las organizaciones sufrió en los últimos 12 meses un incidente de ciberseguridad relacionado con la IA a causa de violaciones de la privacidad de los datos. Y esto es sólo lo que se sabe.
IA en la sombra.
Existen las IA en la sombra, que son básicamente IA no autorizada que la gente despliega dentro del entorno (antes era un USB con un virus, hoy es un agente asistente). Esas cosas carecen de controles de seguridad que una buena política de seguridad deberían tener.
Chatbots de nube pública.
Y luego está el uso de chatbots de nube pública, estas cosas donde la gente entra y hace sus preguntas, pero también pueden incluir una hoja de cálculo con información confidencial. Bueno, una vez que eso va a un chatbot público, se convierte en información pública, porque siempre los autorizas a usar esa información confidencial para entrenar sus modelos y luego está disponible para todos. Yo sé que no te leíste las 57 páginas del TOS.
Las preguntas que tenemos que responder
Así que también, tenemos preguntas que responder sobre cómo la IA está usando los datos que le aportamos y los datos que ella nos aporta:
- ¿Qué datos usó la IA?
- ¿De dónde sacó esos datos?
- ¿Cómo vamos a gestionar la exposición de los datos de la IA de forma proactiva?
Nuevo Enfoque.
Las herramientas tradicionales de DLP (prevención de pérdida de datos) y de IA no pueden responder estas preguntas. Vamos a necesitar un enfoque diferente. No basta con saber qué herramientas de IA se están utilizando, ¡es un buen punto de partida!. También necesitas saber cómo fluyen los datos confidenciales a través de los sistemas de IA y dónde podrían estar expuestos.
¿Cómo fluyen los datos a través de un sistema de IA?
Echemos un vistazo a una arquitectura de alto nivel para ver a qué me refiero.
Los componentes.
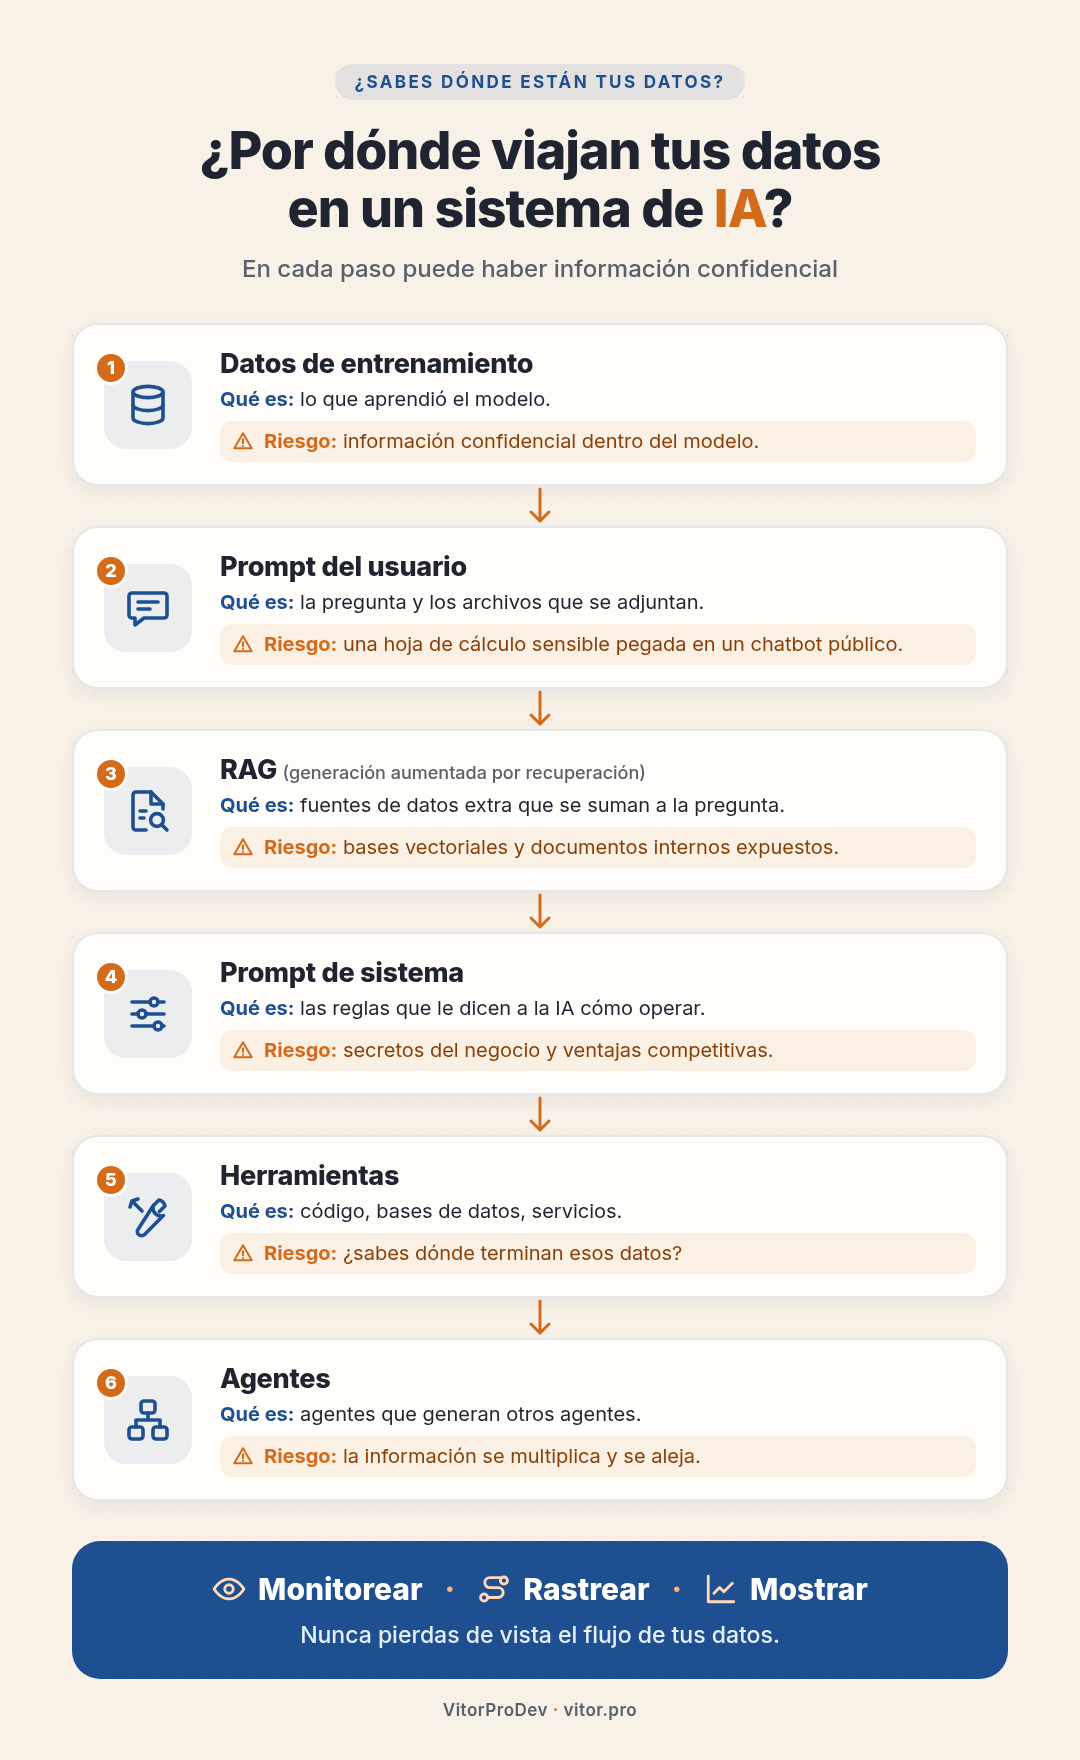
Comienza con los datos de entrenamiento que van a un modelo en particular. Luego tenemos un usuario que introduce una indicación que va a la IA, lo que hará que haga otras cosas. Junto con esa indicación, podemos "aumentarla" con otras fuentes de datos, es decir, la generación aumentada por recuperación o RAG. Luego, tenemos un contexto o una política que anule todo esto, y que podría tener algunos aspectos confidenciales, donde ponemos otra información que le dice a la IA cómo operar y cómo llegar a sus respuestas. Que lo llamaremos "Prompt de Sistema". Luego, si es un agente, extiende su mano y usa diferentes tipos de herramientas. Algunas de esas herramientas pueden escribir código, pueden acceder a bases de datos, pueden, generar otros agentes, que luego van a generar otros agentes (Mi trabajo es ser esclavista de agentes o Master). Bien, ese es el flujo general de cómo va la información y todos los diferentes componentes y cómo interactúan.
Dónde viven los datos confidenciales.
¿Qué tal desde una perspectiva de datos? ¿Qué podría ser confidencial aquí? Datos de entrenamiento. Bueno, podríamos tener información confidencial aquí en los datos de entrenamiento que luego van al modelo. Indicaciones del usuario. Podríamos tener información confidencial aquí que este usuario tiene y que está ingresando con su indicación. Es posible que hayan utilizado una hoja de cálculo o un documento que tenga información confidencial, y eso también va junto con la indicación y entra en la IA. Política y contexto. Es posible que tengamos información confidencial en la política y el contexto, tal vez formas en que hacemos las cosas que consideramos ventajas competitivas que no querríamos que nuestra competencia supiera. Así que esto también se está alimentando en el modelo. Herramientas. Luego, el modelo se extiende y utiliza herramientas. ¿Qué hay de estas herramientas? ¿Qué están haciendo con la información que reciben? ¿La están protegiendo o no? ¿Tenemos control y visibilidad sobre esas herramientas en particular? Si la están escribiendo en una base de datos, ¿sé dónde terminarán esos datos? Y tal vez vaya a otros lugares río abajo. Agentes. Y luego estos agentes, donde estoy tomando información potencialmente confidencial y alimentándola en manos de estos agentes, y luego generan otros agentes. Así que puede ver cuando mira esto que la información confidencial está por todas partes y fluye a través de toda la arquitectura.
Lo que necesitamos saber.
Así que tenemos muchas cosas que tenemos que considerar en este caso:
- Necesitamos saber qué datos confidenciales está utilizando la IA.
- Necesitamos saber cuál es la exposición. ¿Qué datos se están exponiendo? ¿Fue autorizado y fue gobernado?
- Queremos saber cómo investigamos qué sucedió a medida que los datos se mueven a través de la IA.
- ¿Cómo habilitamos la adopción de la IA sin crear brechas de seguridad de datos?
Dos perspectivas: carga de trabajo y fuerza laboral
Vamos a necesitar ser capaces de ejecutar funciones diferentes para ver a dónde van los datos. Voy a ver esto desde un par de perspectivas diferentes. Hay una corriente de carga de trabajo, que está básicamente dentro de los propios sistemas de IA, y la corriente de fuerza laboral, donde este es el uso de la IA por parte de los empleados. ¿Y qué necesito hacer? Necesito monitorear, rastrear y luego poder mostrar cómo se han movido esos datos a través del sistema, cómo se han utilizado y cómo se han expuesto.
La carga de trabajo: dentro de los sistemas de IA
Monitorear.
- Tengo que mirar dentro de las aplicaciones de IA y ver cómo están usando los datos.
- Necesito mirar las canalizaciones de RAG, ver qué información está entrando en el sistema de esa manera.
- Voy a mirar las bases de datos vectoriales, que son el corazón de muchos de estos modelos de IA generativa.
Rastrear.
Luego voy a necesitar ser capaz de rastrear todo esto. Tengo transformaciones de datos que van a ocurrir. La información se veía así, pero ahora está en alguna otra forma. Todavía necesito saber sobre eso. Si lo estoy buscando solo en esta forma, podría pasarlo por alto y no darme cuenta de que los datos se han filtrado. Así que necesito ser capaz de darme cuenta cuando los datos han sido transformados.
Mostrar.
Y luego necesito ser capaz de mostrar todo esto.
- Necesito ser capaz de mostrar las fuentes de donde provienen los datos.
- Necesito ser capaz de mostrar estas transformaciones a las que acabo de referirme.
Y luego, en última instancia, ¿a dónde va toda esta información? Así que esa es la vista desde dentro de la IA.
La fuerza laboral: los empleados
¿Qué hay de la vista dentro de la fuerza laboral? ¿La fuerza laboral o los empleados?
Monitorear.
- En este caso, quiero ver las cargas y descargas de archivos.
- Quiero ver qué cosas pusieron en el sistema.
- Qué cosas sacaron del sistema.
Rastrear.
Quiero ver cuándo hicieron operaciones de copiar y pegar. Tal vez sacaron alguna información confidencial y luego la pegaron en otro lugar. Así que puede ver que los datos ahora viven en un hogar diferente. Tengo que mirar la información secundaria. Así que tengo un archivo principal, y luego hay archivos secundarios que podrían derivarse de eso. Y necesito ser capaz de rastrear todos esos tal como lo hice con el archivo original que tenía la información confidencial.
Mostrar.
- Necesito ser capaz de mostrar cómo los empleados están consumiendo esta información.
- Cómo la están compartiendo con otros empleados también.
Una plataforma unificada de extremo a extremo
Así que todas esas cosas necesitan ser vistas, y necesito ver esto en una plataforma de protección de visibilidad unificada de extremo a extremo. ¿Qué tipo de cosas necesito de eso?
Linaje.
Necesito ser capaz de ver de dónde vinieron los datos y cómo se movieron a través del sistema. Necesito ser capaz de ver cosas como la fuente, luego pasó por esta IA y luego terminó en este sistema de punto final.
Políticas compartidas.
Así que, estas políticas las van a compartir todos, se monitorean y se hacen cumplir. Cada departamento puede y debe tener políticas específicas, siempre que estén subordinadas y circunscritas a las políticas generales.
Un panel transparente único.
No puedo permitirme tener un montón de sistemas de monitoreo que no estén integrados, porque entonces no sé lo que está pasando, no voy a tener contexto.
Identificación de riesgos.
Necesito ser capaz de identificar el riesgo. Necesito una capacidad de identificación de riesgos donde pueda ver todo de manera proactiva, no solo después de que los datos se hayan escapado, no podemos trabajar post mortem.
Los tres ojos
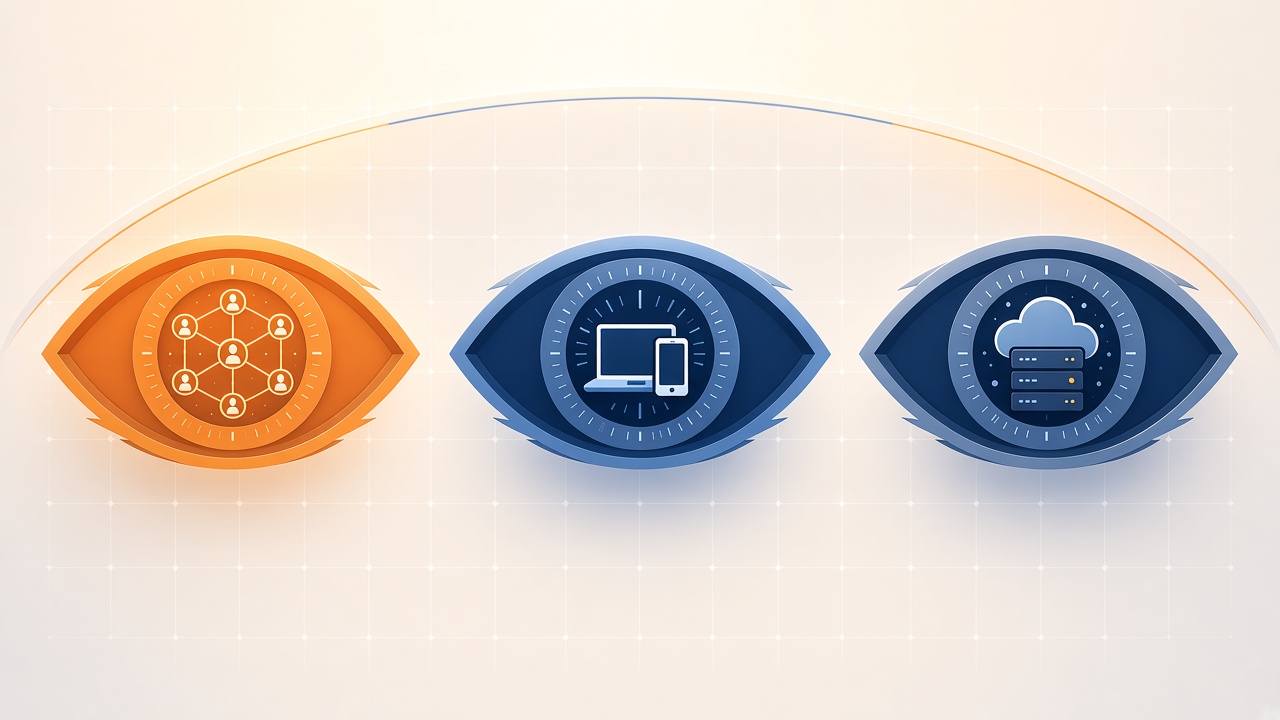
¿Cómo puede obtener el tipo de visibilidad?. Echemos un vistazo a las tres visiones que nos darán referencias y contextos.
1.- Un ojo puesto en los agentes.
Así que comenzaremos con el descubrimiento de la plataforma agéntica, que pueden ser desde LLMs pequeños locales hasta tropas como GrokBot. Y las herramientas que hacen esto podrían responder preguntas como quién indicó qué modelo en particular, y qué agente se ejecutó realmente, qué herramienta MCP se llamó.
2.- Un ojo en los dispositivos de los empleados.
Una herramienta de descubrimiento de DLP (prevención de pérdida de datos) de punto final. Esas herramientas existen, y podrían decirle cosas como qué agentes y extensiones y servidores MCP existen en cada uno de estos dispositivos. Buscar en forma recursiva en archivos, memoria y otros residuos digitales que están en todos los dispositivos de punto final (antes los llamábamos terminales).
3.- Un ojo en la red local y la nube.
La nube o la red local cada vez son más difíciles de distinguir. Alguien diría que la nube es la computadora de otro, pero se supone que uno contrata una nube encriptada con espacio privado y hay empresas que tienen una nube creada con equipos propios. Hay que buscar qué fuentes de datos existen en estas plataformas en particular. También debemos averiguar la clasificación y sensibilidad de los datos que hay allí, y si se puede, la propiedad.
La trampa: ¿viste el problema?
Cada uno de estos ojos solo ve una parte de la imagen. Necesitamos es una visión panorámica que tenga todo esto en cuenta y los integre a todos de forma transparente. ¿Qué se necesita realmente aquí para gestionar la exposición de datos de la IA? Echemos un vistazo a los requisitos.
1.- Hay que estar conscientes de la presencia de la IA.
Tiene que ser continuo, porque el sistema está cambiando constantemente. Necesita reconocer fuentes en todas nuestras plataformas, y necesita ser consciente de los datos confidenciales que tenemos, cosas como información de identificación personal, información de salud personal, datos financieros, propiedad intelectual, todo ese tipo de cosas.
2.- Visibilidad de riesgos impulsada por el linaje.
Que los datos se transforman por RAG. Los agentes y sistemas de IA y cosas de ese tipo también pueden hacer transformaciones. Y luego tenemos que ver cómo se propagan los datos a través del sistema. Y se cambiará a medida que se propague en algunos casos. Es como el juego del teléfono roto o teléfono escacharrado. La gracia está en comparar el mensaje que llegó al final con el original y ver cuánto cambió por el camino. La metadata de este mensaje debe contener su linaje.
3.- Investigación inteligente.
Debemos ser conscientes del contexto, en función de la sensibilidad del usuario, el destino y una serie de otros factores diversos que dependen de la organización y sus partes. Y tenemos que ser capaces acelerar el tiempo de investigación, que suele ser de semanas, a minutos. La velocidad lo es todo.
4.- Informes de cumplimiento.
Hay muchas cosas diferentes que tenemos que considerar: el RGPD (Reglamento General de Protección de Datos), la Ley de IA de la UE, SOC 2, ISO 27001, HIPAA, la lista continúa. Necesitamos ser capaces de ver todas esas cosas y cómo nuestra IA las está cumpliendo o violando.
Conclusión:
El control de datos dentro de una organización que usa IA y que además ya estaba en la nube a veces parece una tarea titánica. Pero las herramientas existen y en el fondo los métodos y procedimientos desarrollados para apoyar el trabajo remoto son un excelente punto de partida. El futuro es inevitable, para bien o para mal las nuevas tecnologías siempre llegan para quedarse, ignorarlas sólo hará que retrasemos lo inevitable o que nunca nos adaptemos a los nuevos paradigmas. El alma de una empresa son sus datos, su herencia y su evolución. Nunca pierdas de vista su flujo.
Si quieres leer más
Si llegaste hasta aquí, ya vas un paso adelante: preguntarte dónde están tus datos es la mejor forma de empezar. Te dejo una selección de lecturas que me han servido para entender el tema con calma, desde las cifras hasta las normas. No hace falta leerlas todas de una vez; elige la que más te sirva hoy y vuelve por las demás cuando quieras.
-
Security Risk Mitigation Strategies for Successful AI Adoption
Omdia (investigación encargada por IBM) · 2026
https://www.ibm.com/downloads/documents/us-en/16ddab5a95547e73
Es el estudio del que sale el 31% que cito en el artículo: una encuesta a 400 profesionales de TI y ciberseguridad de Norteamérica sobre cómo están gestionando el riesgo de adoptar IA (en inglés).
-
Cost of a Data Breach Report 2026
IBM y Ponemon Institute · 2026
https://www.ibm.com/reports/data-breach
El informe anual de referencia sobre el costo de las filtraciones; este año muestra que los incidentes con IA en la sombra pasaron del 20% al 43% de los casos, una buena razón para conocer qué herramientas usa tu equipo (en inglés).
-
LLM08:2025 Vector and Embedding Weaknesses
OWASP Gen AI Security Project (OWASP Top 10 for LLM Applications) · 2025
https://genai.owasp.org/llmrisk/llm082025-vector-and-embedding-weaknesses/
Explica de forma práctica cómo un sistema RAG y su base de datos vectorial pueden filtrar información, y qué controles de acceso y registro ayudan a evitarlo (en inglés).
-
AI Data Security: Best Practices for Securing Data Used to Train & Operate AI Systems
CISA, NSA, FBI y socios internacionales · 2025
Una guía para proteger la seguridad y la integridad de los datos en todas las fases del ciclo de vida de la IA, desde el desarrollo hasta la operación; muy útil para pensar en el recorrido completo de tus datos (en inglés).
-
Reglamento (UE) 2024/1689 (Reglamento de Inteligencia Artificial)
EUR-Lex, Diario Oficial de la Unión Europea · 2024
https://eur-lex.europa.eu/legal-content/ES/TXT/?uri=CELEX:32024R1689
El texto oficial en español de la Ley de IA de la UE; conviene tenerlo a mano para saber qué se espera de quien desarrolla o usa sistemas de IA.
-
Reglamento (UE) 2016/679 (Reglamento general de protección de datos, RGPD)
EUR-Lex, Diario Oficial de la Unión Europea · 2016
https://eur-lex.europa.eu/legal-content/ES/TXT/?uri=CELEX:32016R0679
La base de todo lo que tiene que ver con datos personales en Europa, también cuando esos datos pasan por un modelo de IA.
-
ISO/IEC 42001:2023 – AI management systems
ISO · 2023
https://www.iso.org/standard/42001
La norma internacional para establecer un sistema de gestión de la IA; es un buen complemento de ISO/IEC 27001 si tu organización quiere ordenar su gobierno de la IA.