
Vítor Jaime de Oliveira · VitorProDev · Caracas
El contexto
Hermes es la pieza que coordina mis agentes de programación. Recibe una tarea, decide qué herramienta llamar, con qué argumentos y en qué orden, y aguanta conversaciones largas donde la información llega a pedazos. Para ese papel no busco el modelo que mejor escribe código. Busco el que mejor elige herramientas, el que no las llama cuando no hace falta y el que sabe recuperarse cuando le falta algo.
Todo corre en local, con llama.cpp y modelos GGUF, sobre un Mac Studio con chip M2 Max y 96 GiB de memoria unificada. Los candidatos fueron Qwen3.6-27B, que es lo que uso hoy, y Qwen3.8-27B, la versión nueva. Los dos son de 27B y los dos corrieron en Q8_0. La pregunta era simple: ¿vale la pena cambiar el modelo principal de Hermes?
La respuesta corta es que depende del tipo de trabajo. La larga está en los números.
Metodología
La idea fue darles a los dos exactamente las mismas condiciones y dejar todo escrito para que cualquiera pueda repetirlo.
Modelos
- Qwen3.6-27B, cuantización Q8_0, GGUF de unsloth/Qwen3.6-27B-GGUF, 28.595.763.424 bytes. sha256: f93f517f38e696d35a1a7df2c0e3155a64f4c4dcd662107a146ae263f7fb14ce (coincide con el oid LFS de Hugging Face).
- Qwen3.8-27B, cuantización Q8_0, 29.047.086.048 bytes. El sha256 de este archivo todavía no está calculado.
Antes de esta comparación tenía una configuración injusta: el 3.6 corría en UD-Q6_K_XL, con 64k de contexto y temperatura 0.6, y el 3.8 tenía decodificación especulativa con MTP (--spec-type draft-mtp) y --reasoning-budget 16384. Todo eso se reemplazó antes de correr las pruebas.
llama.cpp
Usé llama-server versión 0.6.0-dev, build 11479 (commit 42c787e8c), compilado con AppleClang 21 para Darwin arm64. Las dos corridas reportan el mismo build. Estos son los comandos de los dos servidores:
llama-server -m ~/Models/qwen-36-27B-Q8/Qwen3.6-27B-Q8_0.gguf -a qwen-36-27 --jinja -np 1 -c 131072 -ctk f16 -ctv f16 --flash-attn on -ngl 999 -b 2048 --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0 --presence-penalty 0 --repeat-penalty 1.0 --chat-template-kwargs {"preserve_thinking":true} --host 127.0.0.1 --port 8093

llama-server -m ~/Models/Qwen-38-27B-Q8/Qwen3.8-27B-Q8_0.gguf -a qwen3.8-27b --jinja -np 1 -c 131072 -ctk f16 -ctv f16 --flash-attn on -ngl 999 -b 2048 --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0 --presence-penalty 0 --repeat-penalty 1.0 --host 127.0.0.1 --port 8090
Los dos tienen 131.072 tokens de contexto, un solo slot, caché KV en f16, flash attention y todas las capas en GPU. La única diferencia es preserve_thinking=true en el 3.6: según la ficha, el 3.8 ya lo trae activado por defecto. El 3.8 usa su reasoning_effort por defecto (xhigh). Ninguno de los dos tiene presupuesto de razonamiento ni MTP. La temperatura es 1.0 en los dos, con top-p 0.95 y top-k 20, que es la configuración de la ficha para el modo con razonamiento. La seed del servidor es aleatoria.
Benchmarks
Usé dos suites.
BFCL v4 (bfcl-eval 2026.3.23, versión tomada del kit y no comprobada otra vez en el entorno) en modo function calling, con un subconjunto fijo de 165 casos:
- multiple, parallel_multiple, live_multiple y live_irrelevance: 30 casos cada una;
- multi_turn_base, multi_turn_miss_func y multi_turn_miss_param: 15 casos cada una.
El subconjunto se genera con un script propio de preparación con la semilla 20261009. Comprobé con cmp que la lista de IDs de casos es idéntica en las dos corridas. BFCL corre con un solo hilo, igual que el servidor.
τ²-bench, dominio airline, split test: 20 tareas, 1 trial, seed 300, máximo de 100 pasos, timeout de 3600 s por simulación y concurrencia 1. El commit de tau2-bench es fc0055dc4e0a316c3f83133267fbd6faaa770992, del 16 de julio de 2026. El cliente simulado de τ² fue el mismo en las dos corridas: Qwen3.6 en el puerto 8093, con temperatura 0 y sin razonamiento. Más abajo explico por qué eso importa.
No usé prompts propios. Los prompts de sistema son los de BFCL y los de la política airline de τ².
Cómo se ejecuta
Un script de arranque corre todo para un solo modelo. No toca los servidores, que tienen que estar levantados de antes:
./arranca qwen36 # o qwen38
Por dentro hace tres pasos:
bfcl generate --model qwen36-local-FC --test-category multiple,parallel_multiple,live_multiple,live_irrelevance,multi_turn_base,multi_turn_miss_func,multi_turn_miss_param --temperature 1.0 --num-threads 1 --run-ids --allow-overwrite
bfcl evaluate --model qwen36-local-FC --test-category <las mismas> --partial-eval
tau2 run --domain airline --task-split-name test --num-trials 1 --seed 300 --max-steps 100 --timeout 3600 --max-concurrency 1 --agent-llm openai/qwen-36-27 --agent-llm-args '{"temperature":1.0,...}' --user-llm openai/qwen-36-27 --user-llm-args '{"temperature":0.0,"extra_body":{"chat_template_kwargs":{"enable_thinking":false}}}'
Hubo una corrida por modelo, siempre de a una. El 3.6 corrió del 9 de octubre a las 23:17 al 10 de octubre a las 09:12 (9 h 55 min). El 3.8 corrió el 10 de octubre de 09:14 a 18:08 (8 h 54 min).
Resultados
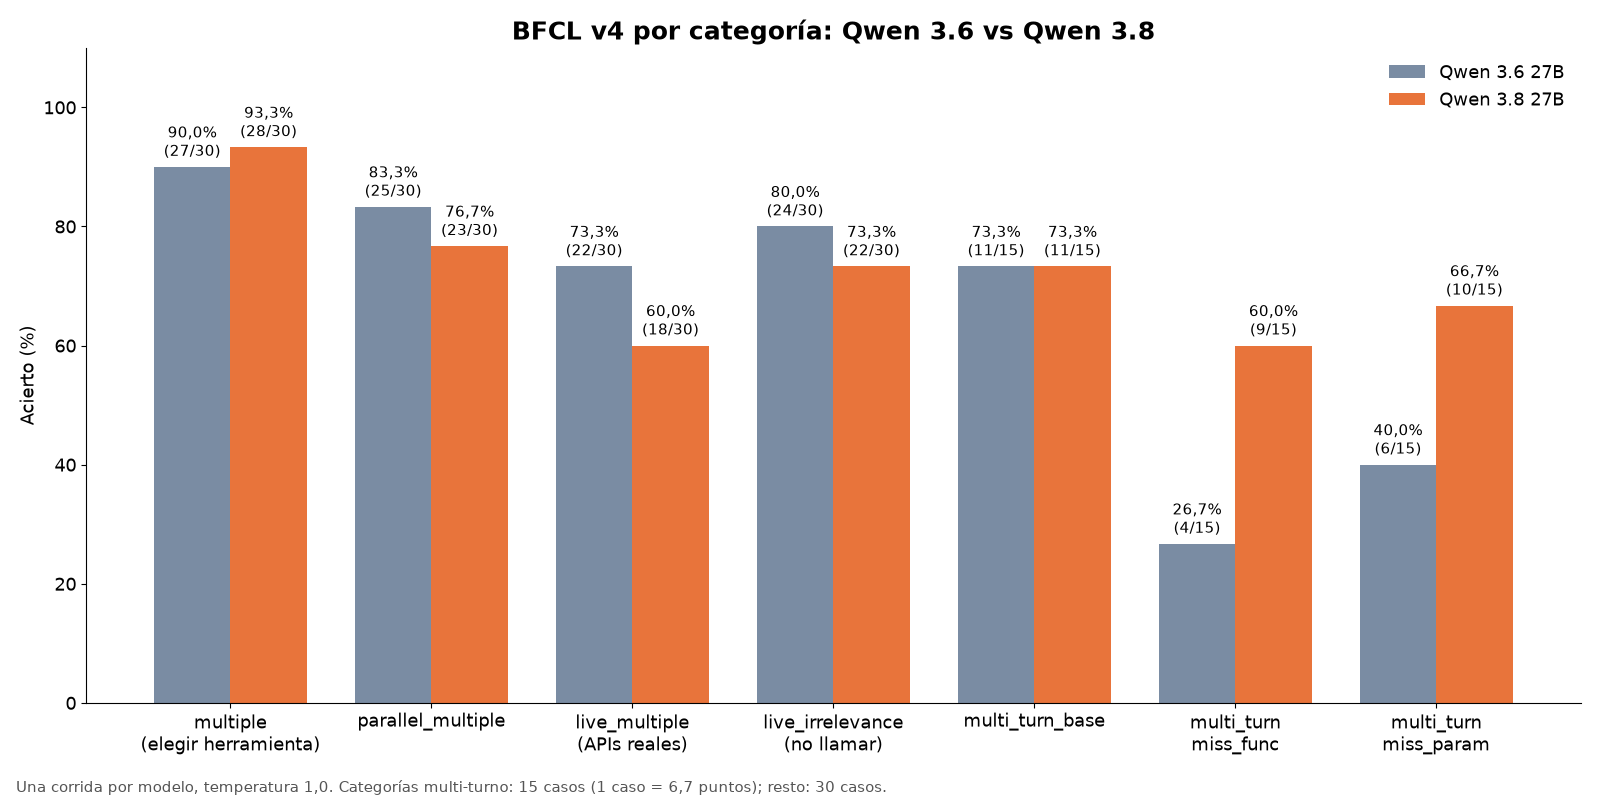
| Prueba | Qwen3.6-27B | Qwen3.8-27B |
|---|---|---|
| BFCL multiple (elegir herramienta) | 27/30 (90.0 %) | 28/30 (93.3 %) |
| BFCL parallel_multiple (llamadas paralelas) | 25/30 (83.3 %) | 23/30 (76.7 %) |
| BFCL live_multiple (APIs reales) | 22/30 (73.3 %) | 18/30 (60.0 %) |
| BFCL live_irrelevance (no llamar herramientas) | 24/30 (80.0 %) | 22/30 (73.3 %) |
| BFCL multi_turn_base | 11/15 (73.3 %) | 11/15 (73.3 %) |
| BFCL multi_turn_miss_func (falta una función) | 4/15 (26.7 %) | 9/15 (60.0 %) |
| BFCL multi_turn_miss_param (falta un parámetro) | 6/15 (40.0 %) | 10/15 (66.7 %) |
| Latencia BFCL por caso: media / p95 | 33.7 s / 124 s | 25.8 s / 69 s |
| τ² airline (media de reward) | 0.7778 sobre 18 tareas; 0.70 sobre 20 contando los 2 errores como fallo | 0.80 sobre 20 |
| Duración total de la corrida | 9 h 55 min | 8 h 54 min |
| Smoke SWE (2 tareas): resueltas | 1/2 | 1/2 |
| Smoke SWE: generación | ~12 tok/s | ~12 tok/s |
| Smoke SWE: RSS máximo de llama-server | 32.0 GB | 32.4 GB |
No incluyo el «Overall Acc» que trae el CSV de BFCL (19.50 % contra 23.47 %) porque se calcula también sobre categorías que no corrí y no significa nada en este contexto. Tampoco incluyo el «Total Cost», que en un modelo local es un valor ficticio.
Análisis por área
Una llamada bien hecha: gana el 3.6
En las categorías de un solo turno con APIs reales, el 3.6 es claramente mejor. En live_multiple saca 73 contra 60. Son cuatro casos de diferencia sobre 30, y es la brecha más grande a su favor. En live_irrelevance, donde lo correcto es no llamar ninguna herramienta, saca 80 contra 73. En llamadas paralelas, 83 contra 77. Solo en multiple, que es elegir la herramienta correcta entre varias, el 3.8 va un caso por delante (93 contra 90).
Los fallos también dicen algo. Los dos modelos fallan el mismo caso de live_irrelevance (encienden un aire acondicionado cuando no se lo pidieron). En otro caso, el 3.8 lanza dos peticiones a servicios de geolocalización de IP cuando la respuesta correcta era no llamar nada. Para un orquestador, esa tendencia a «hacer algo» tiene un costo: cada llamada innecesaria es tiempo y, a veces, un efecto secundario.
Recuperarse cuando falta algo: gana el 3.8, y por mucho
Las categorías de varios turnos son las que más se parecen a lo que hace Hermes en la práctica. En el caso base empatan: 11 de 15 cada uno. Pero cuando el escenario esconde una función o deja un parámetro sin dar, el 3.8 se separa: 60 contra 27 cuando falta una función y 67 contra 40 cuando falta un parámetro. Son las diferencias más grandes de toda la prueba.
Entre los fallos del 3.6 aparecen casos interrumpidos a la fuerza porque el modelo se queda dando vueltas con cd y ls, y turnos con respuesta vacía. En un orquestador eso es lo peor que puede pasar: un agente que no avanza ni pide lo que le falta.
Velocidad: gana el 3.8
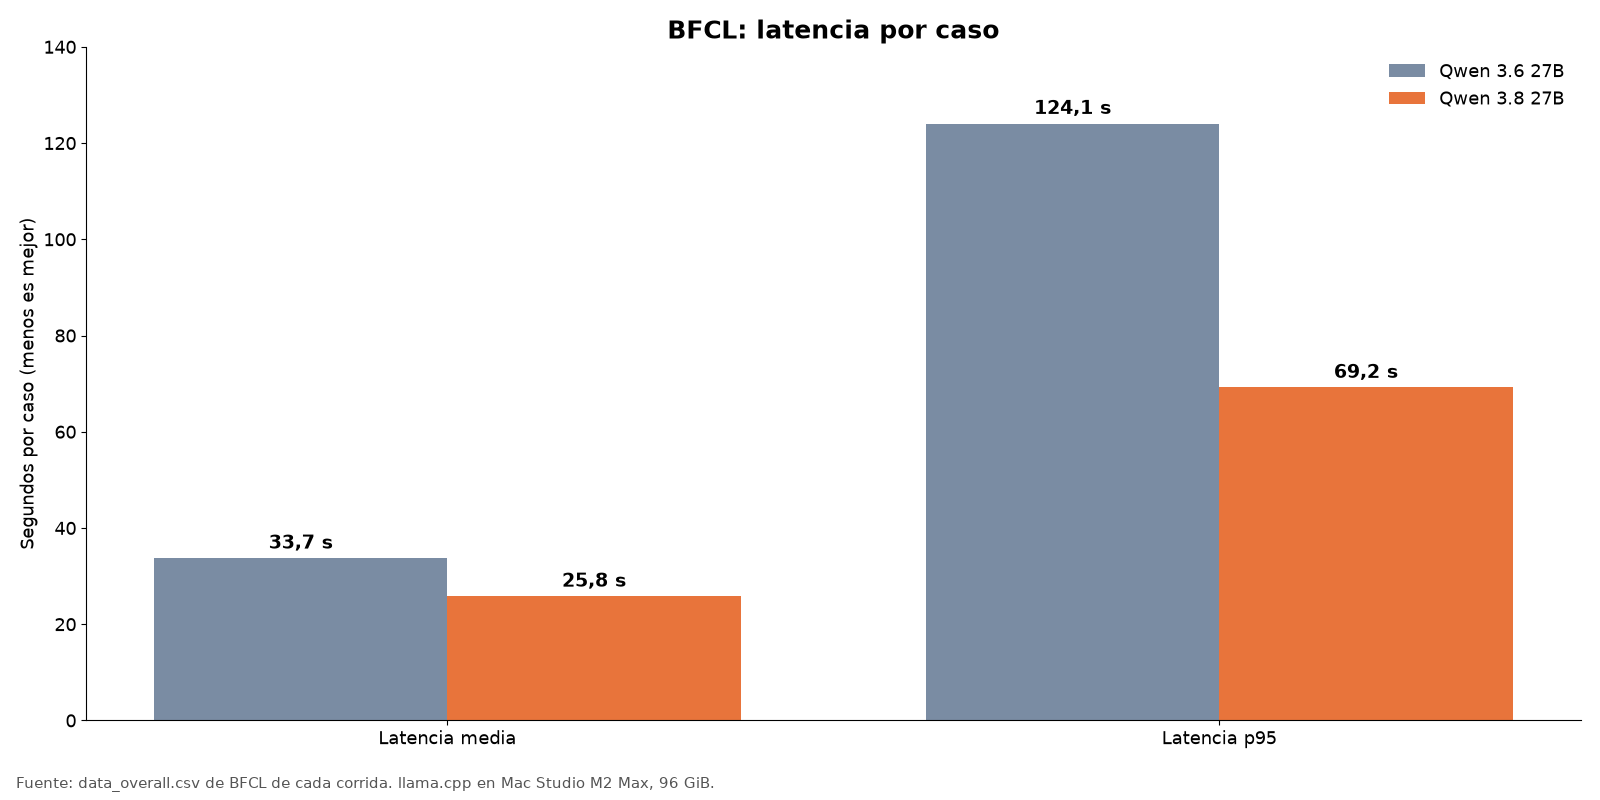
Por caso de BFCL, el 3.8 responde en 25.8 s de media contra 33.7 s del 3.6, y su p95 baja de 124 s a 69 s. La corrida completa también terminó una hora antes. El p95 importa más que la media cuando hay agentes esperando: es la cola larga la que bloquea un pipeline.
Esto no es velocidad de generación. En el smoke los dos generan a unos 12 tok/s. La diferencia está en cuántos tokens gasta cada uno para llegar a la llamada.
τ² airline: prácticamente empate
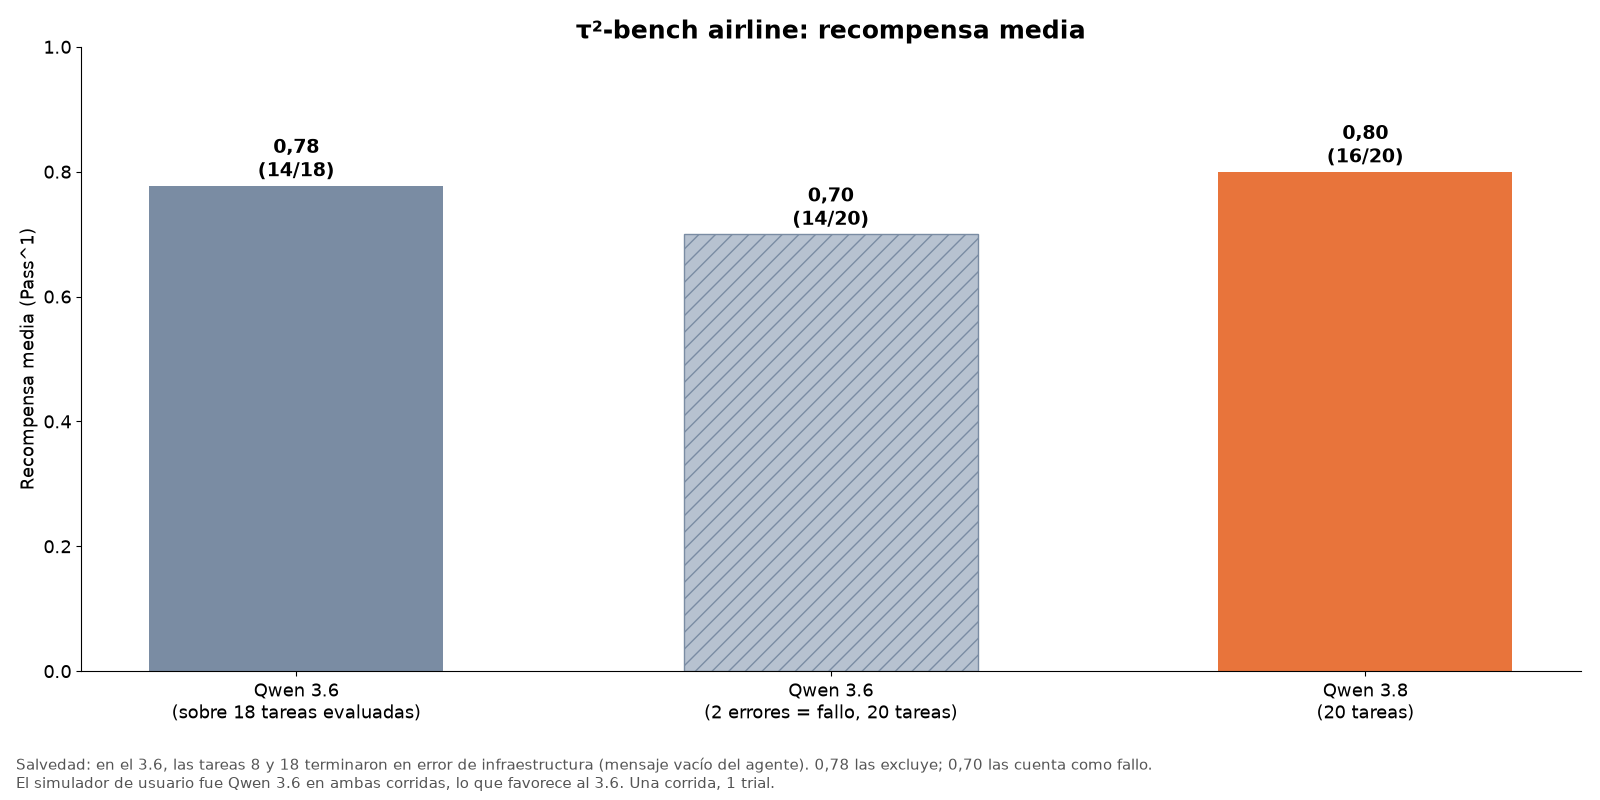
El 3.8 saca 0.80 sobre 20 tareas, con 33 de 34 acciones de lectura correctas y 16 de 23 de escritura. El 3.6 saca 0.7778, pero sobre 18 tareas: en dos (la 8 y la 18) el agente devolvió un mensaje vacío y τ² las marcó como error de infraestructura. Si esas dos cuentan como fallo, queda en 0.70.
En las 18 tareas que completaron los dos, los fallos casi coinciden (tareas 24, 29 y 35, más la 44 para el 3.6 y la 18 para el 3.8). Mi lectura es que en este dominio están parejos, y que el sesgo del simulador, que explico abajo, juega a favor del 3.6.
Smoke de SWE-bench: no decide nada
En dos tareas de SWE-bench Verified ejecutadas de forma nativa en macOS, cada modelo resolvió una (la misma, django-17029), y el 3.6 lo hizo en menos tiempo: 307 s contra 541 s. Con dos tareas eso es anecdótico, y no se puede comparar con el leaderboard. Lo que sí deja el smoke son las únicas medidas de memoria y de velocidad de generación que tengo.
Y es que no uso estos modelos para programar: a unos 12 tok/s son lentos para eso. En mi caso de uso, el modelo local orquesta y los agentes de programación escriben el código. Por eso el smoke de SWE se hizo solo para medir RAM y velocidad, y no hacía falta una corrida completa de SWE-bench.
Limitaciones
Prefiero decirlas claras antes que alguien las descubra:
- Una sola corrida por modelo, con temperatura 1.0 y seed de servidor aleatoria. Con esa temperatura, otra corrida podría mover varios puntos.
- Muestras pequeñas. Las categorías de varios turnos tienen 15 casos, así que un caso vale 6.7 puntos. Las de un turno tienen 30, y un caso vale 3.3. Las diferencias de uno o dos casos (multiple, parallel_multiple, live_irrelevance) no son concluyentes. Las de multi-turno, de cuatro y cinco casos, pesan más, pero tampoco son definitivas.
- El simulador de cliente de τ² era el propio Qwen3.6, con temperatura 0 y sin razonamiento. En la corrida del 3.6, el modelo se hablaba a sí mismo, lo que lo sesga a su favor. Aun así, el 3.8 no salió peor.
- Dos errores técnicos del 3.6 en τ² (mensaje vacío del agente). Por eso doy las dos cifras, 0.7778 sobre 18 y 0.70 sobre 20.
- Memoria y tokens/s solo se midieron en el smoke de SWE, no durante BFCL ni τ². Los unos 32 GB y unos 12 tok/s salen de ahí. En algún momento vi al 3.8 ocupar unos 45 GB con 128k de contexto, pero es una observación suelta y no la doy como dato.
- Pendientes sin confirmar:
- el sha256 del GGUF del 3.8 no está calculado;
- la versión de bfcl-eval (2026.3.23) se tomó del kit y no se volvió a comprobar en el entorno;
- no está verificado que el commit de tau2-bench corresponda a la v1.0.1;
- que en el modo FC de BFCL el razonamiento no vuelva al modelo entre turnos sale de la configuración y no se revisó línea por línea.
- Todo es con llama.cpp y GGUF Q8_0 en un M2 Max. Otra cuantización u otro backend pueden dar otro resultado.
Conclusión práctica
Si tu orquestador vive de conversaciones largas, donde el agente tiene que darse cuenta de que le falta una herramienta o un dato y reaccionar, el 3.8 es mejor opción. Se recupera mucho mejor en varios turnos, responde más rápido y tiene una cola de latencia mucho más corta. Para Hermes, que pasa la mayor parte del tiempo haciendo eso, es razón suficiente para probarlo como modelo principal.
No lo haría a ciegas. El 3.6 sigue siendo más preciso en llamadas únicas contra APIs reales y más disciplinado para no llamar herramientas cuando no hace falta. Si tu flujo es más de «una petición, una llamada bien formada», no hay motivo para cambiar. Mi recomendación mesurada es pasar al 3.8 como orquestador, vigilar las llamadas innecesarias y los argumentos de APIs reales, y repetir la prueba con más corridas antes de darlo por cerrado. Con una corrida y 15 casos por categoría, esto es una buena señal, no un veredicto.